Индустрия окончательно переросла наивный «vibe coding» и пытается обуздать агентов строгими системными рамками. Главный тренд недели — детерминированная оркестрация и аудит исполнения: отказ от плоских строковых логов в пользу деревьев вызовов на AsyncLocalStorage, прерывание бесконечных циклов через фингерпринтинг аргументов и изоляция памяти агентов в Kubernetes. Параллельно в проде закрепляется прагматизм: вместо дообучения моделей инженеры внедряют библиотеки проверенных SQL-паттернов, защищают сгенерированный HTML отдельными доменами и жестко тестируют контракты тулов через Zod и Vitest.
⚡
Главные статьи недели
01
Многоарендная и многоуровневая память AI-агентов на Kubernetes
Финальная часть практического цикла о построении отказоустойчивой памяти агентов в распределённой инфраструктуре. Автор развёртывает Kubernetes-оператор KAOS с библиотекой Mem0 и векторным хранилищем PostgreSQL/pgvector, обеспечивая надёжную изоляцию контекста между пользователями и защищая систему от случайных утечек корпоративных данных.
🔑 Главное
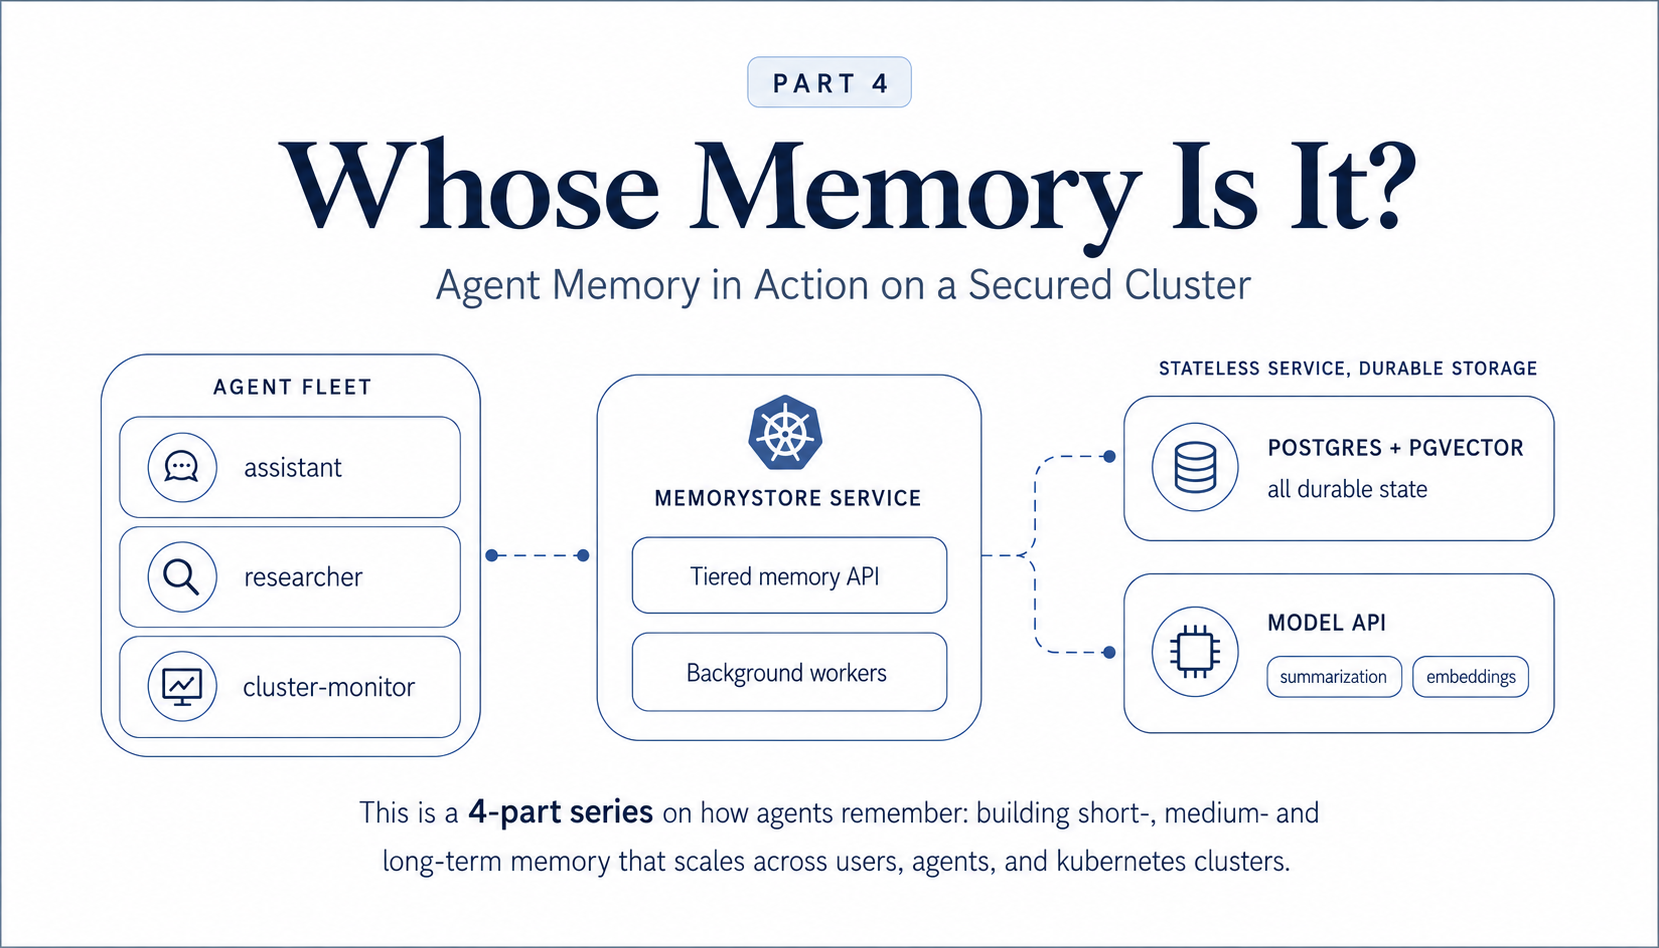
Разделение памяти агентов на три слоя: оперативная память сессии, среднесрочный кэш диалога и постоянное векторное хранилище фактов в pgvector.
Модель скоупов на базе подтверждённой идентичности: каждый блок памяти привязывается к паре «арендатор + агент», что исключает подмешивание чужих данных при похожих вопросах.
Инфраструктурный ресурс MemoryStore в виде Kubernetes CRD с детерминированной топологией репликации и контрактом обработки сетевых сбоев.
Изоляция подтверждена нагрузочными тестами: попытки перекрёстного доступа между независимыми пользователями поддержки отсекаются на уровне хранилища.
Слабое место: Архитектура требует поддержки полноценного кластера Kubernetes и развёртывания оператора MemoryStore, что избыточно для одиночных автономных агентов.
⚡ Попробовать за вечер
Развернуть локальный кластер minikube и применить CRD-манифест MemoryStore из репозитория KAOS.
Интегрировать библиотеку Mem0 в тестовый агент на Python, задав обязательные метаданные tenant_id и scope в конфигурации хранилища.
Запустить два параллельных сеанса разных пользователей и проверить изоляцию: отправить запрос от имени второго клиента с инструкцией выдать факты первого.
Метрика: 0 фактов первого пользователя в ответе модели и 100% изоляция векторов в pgvector при фильтрации по tenant_id.
from article
На схеме: распределение ответственности между флотом агентов, сервисом MemoryStore и постоянным векторным хранилищем pgvector.
Разбор фундаментальной проблемы наблюдаемости: классические последовательные логи рассчитаны на линейные HTTP-запросы, тогда как агент ветвится, повторяет шаги и передаёт промежуточные результаты другим агентам. Автор показывает, как связать асинхронные события в единое дерево причинности с помощью встроенного в Node.js механизма AsyncLocalStorage.
🔑 Главное
Плоский поток логов с временными метками теряет структуру причинности при параллельных вызовах инструментов и повторных попытках.
Использование AsyncLocalStorage из модуля node:async_hooks для сквозного сохранения traceId, spanId и роли агента без ручной передачи параметров.
Обязательная фиксация границ шагов: длительность, статус, тип операции (llm, tool, policy) и устойчивый идентификатор родительского узла.
Структурный diff между прогонами позволяет мгновенно выявить первое расхождение логики (например, запуск генерации текста до обязательной проверки политик).
Слабое место: AsyncLocalStorage работает строго в рамках одного процесса Node.js; при передаче задач через очереди брокеров контекст OpenTelemetry нужно пробрасывать вручную.
⚡ Попробовать за вечер
Создать глобальный контекст через new AsyncLocalStorage() и обернуть запуск воркфлоу агента в метод run().
Добавить в логгер логику автоматического прикрепления текущего spanId и parentSpanId к каждому вызову инструмента.
Сравнить структурированные JSON-следы успешного и деградировавшего прогона через diff по полям document_count и policy_result.
Метрика: локализация сбойного шага в ветке параллельного поиска менее чем за 60 секунд без чтения сотен строк плоского лога.
from article
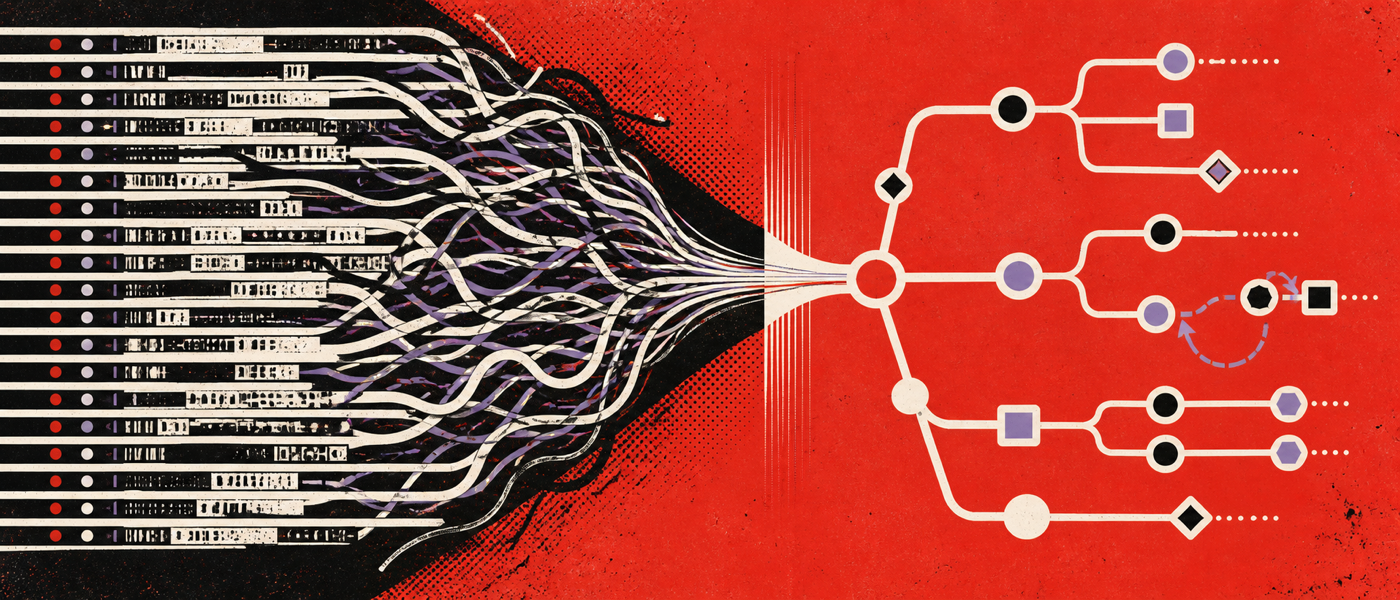
На иллюстрации: переход от спутанного плоского потока логов к древовидной структуре исполнения с контрольными точками.
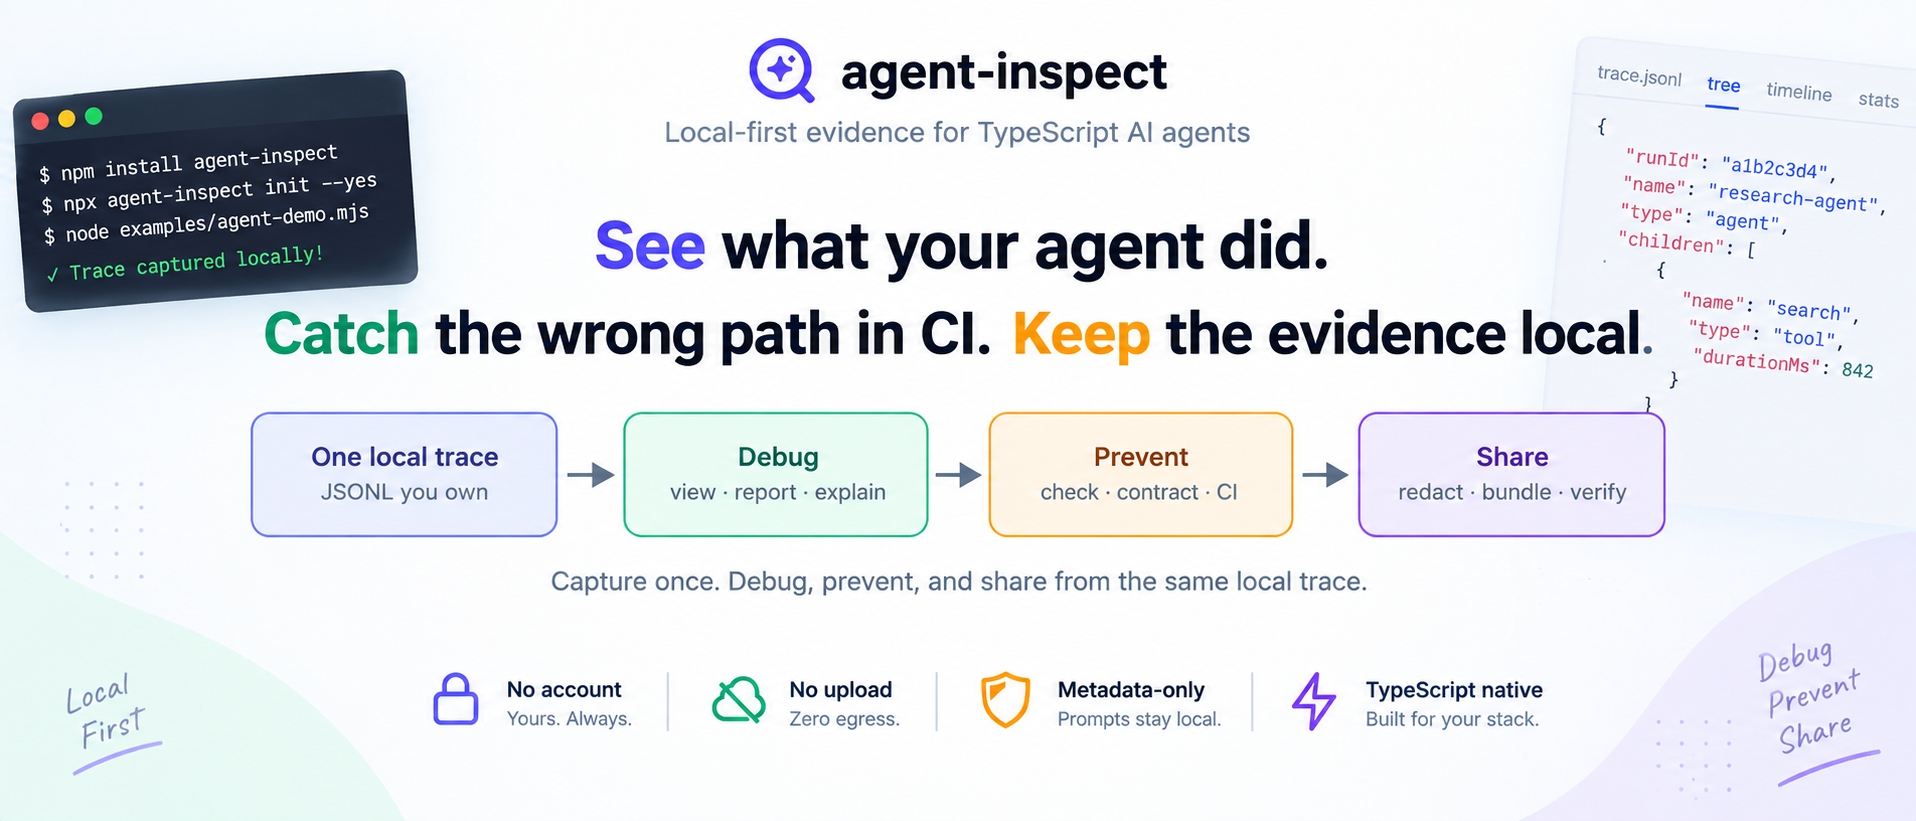
Правдоподобный ответ модели не означает корректность процесса: агент может выдать убедительный текст, вызвав запрещённый инструмент или пропустив чтение документации. Автор представляет библиотеку agent-inspect, которая фиксирует траекторию исполнения локально и превращает её в детерминированный гейт для CI-пайплайнов.
🔑 Главное
Локальная запись траектории прогона в формате JSONL без отправки конфиденциальных данных на сторонние SaaS-платформы.
Сохранение только безопасных метаданных по умолчанию: имена шагов, классы инструментов, длительность, токены и статус без сырых промптов.
Детерминированная проверка в CI командой npx agent-inspect check с флагами обязательных и запрещённых инструментов.
Декларативный API defineTraceContract для программной валидации завершённости шагов и перехваченных сбоев в тестах.
Слабое место: Требует явного оборачивания функций агента в inspectRun и step; сторонние SDK без интеграции не попадут в отчет.
⚡ Попробовать за вечер
Установить инструмент командой npm install agent-inspect и обернуть запуск агента в функцию inspectRun.
Разметить шаги вызова инструментов через await step('retrieve_policy', () => ...) с указанием типа действия.
Добавить в CI шаг автоматической проверки: npx agent-inspect check --dir .agent-inspect --preset trajectory --required-tool retrieve_policy --forbidden-tool search_docs.
Метрика: падение CI с кодом 1 при попытке агента использовать несанкционированный тул search_docs вместо предписанного регламента.
from article
На схеме: архитектурный пайплайн agent-inspect от захвата локального трейса до автоматических проверок контрактов в CI.
Инструкции в промпте «не повторяй действия» не спасают от циклов: агент циклится, когда оркестратор раз за разом возвращает ему пустое или неизменное состояние среды. Автор предлагает архитектурное решение проблемы через нормализацию ответов тулов, хеширование аргументов и ведение явных маркеров продуктового прогресса.
🔑 Главное
Нормализация вывода инструментов: возврат явного статуса status: 'empty' с подсказкой дальнейшего действия вместо пустого массива, провоцирующего повтор.
Вычисление детерминированных отпечатков sanitizedArgsFingerprint и resultFingerprint для детекции тождественных вызовов.
Отказ от подсчёта абстрактных шагов (turn limit) в пользу отслеживания продуктовых маркеров (intent_classified, search_completed).
Лимиты повторных попыток (retry budget) с экспоненциальной задержкой и джиттером при временных сетевых ошибках зависимостей.
Слабое место: Вычисление отпечатков аргументов требует строгой нормализации схемы данных; динамические метки времени или случайные ID приведут к ложным пропускам дубликатов.
⚡ Попробовать за вечер
Ввести в состояние агента структуру AgentState с набором маркеров прогресса progress: Set<string>.
Реализовать нормализатор ответов инструментов: при нулевых результатах поиска возвращать статус empty и запрещать повторный поиск с теми же параметрами.
Добавить в оркестратор проверку перед выполнением тула: если фингерпринт совпал с прошлым шагом и новых маркеров прогресса не появилось, принудительно переводить агента на ветку диалога с пользователем.
Метрика: предотвращение зависания в бесконечной петле ровно на втором повторе с сохранением контекста ошибки.
from article
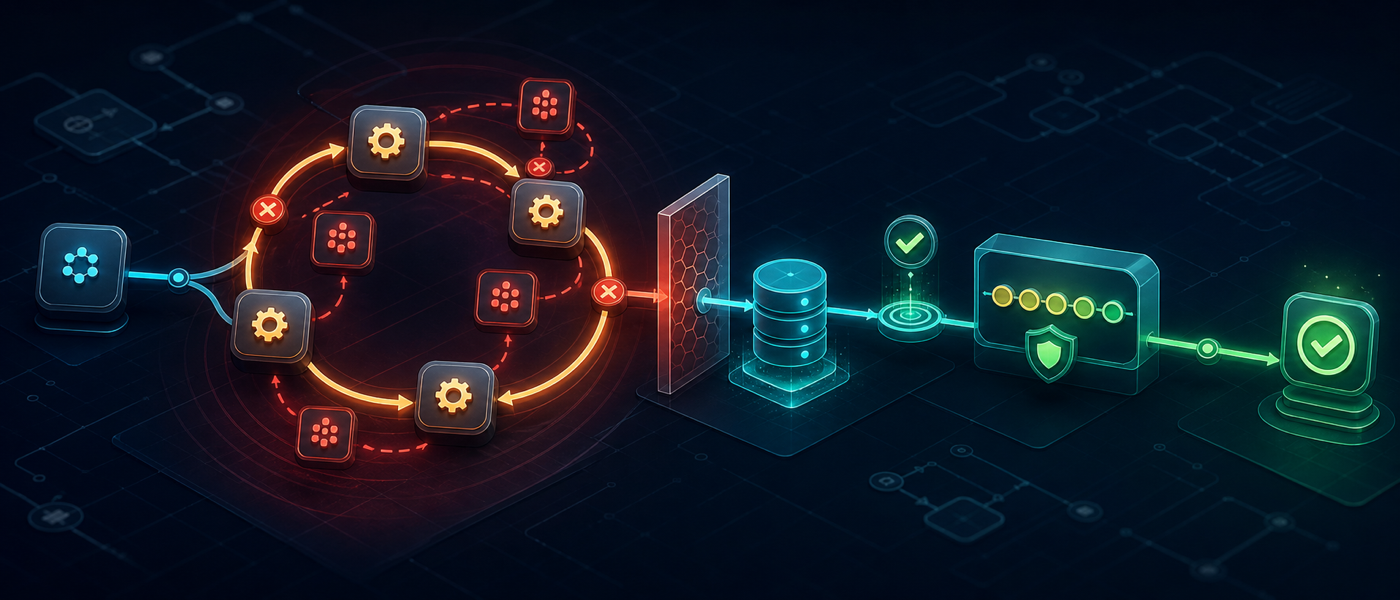
На схеме: переход от зацикленных холостых вызовов к валидации состояния и переходу к следующему этапу сценария.
Три рубежа безопасности для хостинга недоверенного HTML, сгенерированного LLM
✍ Islam GagievHackerNoon⏱ ≈15 минai-generated-htmluntrusted-html
О чём
Когда ассистент генерирует автономные интерактивные HTML-страницы и дэшборды для клиентов, prompt injection превращается в угрозу выполнения произвольного JS на корпоративных ноутбуках. Автор проектирует боевую инфраструктуру хостинга артефактов на базе трёх изоляционных рубежей, опирающихся на механизмы защиты самого браузера.
🔑 Главное
Рубеж 1 (Identity): отказ от signed tokens в URL; ссылка всегда ведёт на основной домен, где права доступа проверяются заново при каждом открытии страницы.
Рубеж 2 (Origin): вынос отображения на полностью отдельный регистрируемый домен (не субдомен!), обеспечивающий Site Isolation на уровне отдельных процессов операционной системы.
Передача HTML-кода через статический шим и postMessage с одноразовым криптографическим nonce без создания публичных эндпоинтов для скачивания сырого файла.
Рубеж 3 (Capability): строжайший заголовок CSP (default-src 'none') и запуск внутри фрейма sandbox="allow-scripts" без allow-same-origin, блокирующий любые сетевые запросы наружу.
Слабое место: Chromium сохраняет страницы в back/forward cache даже при заголовке Cache-Control: no-store; для полной защиты требуется обработчик pageshow с принудительной перезагрузкой.
⚡ Попробовать за вечер
Зарегистрировать вспомогательный домен для пользовательского контента и настроить на нём раздачу единственного статического HTML-шима.
Реализовать защищённое рукопожатие между основным сервисом и iframe через window.postMessage с валидацией origin и одноразового nonce.
Разбор производственного бага: корпоративный ассистент назвал сотруднику устаревший срок декретного отпуска (ошибка на 4 года), выбрав регламент 2021 года вместо актуального с перевесом по косинусной близости всего в 0.008. Автор доказывает, что качество поиска ограничено инжестией, и полностью перестраивает схему базы данных PostgreSQL.
🔑 Главное
Информация, разделяющая актуальный и архивный документы (дата вступления в силу), была стёрта при наивном первичном парсинге текста.
Новая схема таблицы chunks: поля source_path, heading_path (цепочка заголовков), effective_date, status ('current'/'superseded') и content_hash.
Структурный чанкинг с добавлением контекстных заголовков: каждый фрагмент знает своё точное положение в иерархии разделов документа.
Механизм аннулирования устаревших данных (Supersession Marking): при заливке новой редакции старые чанки помечаются как superseded_by и исключаются частичным индексом WHERE status = 'current'.
Слабое место: Извлечение точной даты регламента (effective_date) требует разработки кастомных парсеров под каждый отдельный тип входящих корпоративных документов.
⚡ Попробовать за вечер
Добавить в таблицу векторов колонки heading_path TEXT[], effective_date DATE и статус документа.
Создать частичный индекс HNSW: CREATE INDEX ON chunks USING hnsw (embedding vector_cosine_ops) WHERE status = 'current'.
Настроить скрипт инжестии: при обнаружении свежей версии файла автоматически проставлять предыдущим чанкам статус superseded.
Метрика: полное исключение устаревших версий политик из топ-5 выдачи RAG без потери точности сопоставления.
Схема инжестии данных: обогащение метаданными и вытеснение старых редакций документов
Практический опыт настройки Kiro IDE для метода Spec-Driven Development: планирование фичи до написания кода и пошаговая реализация агентом. Автор собирает легковесный репозиторный сетап из четырёх базовых компонентов в папке .kiro/, который защищает контекстное окно модели от перегрузки и предотвращает рассинхронизацию с тестами.
🔑 Главное
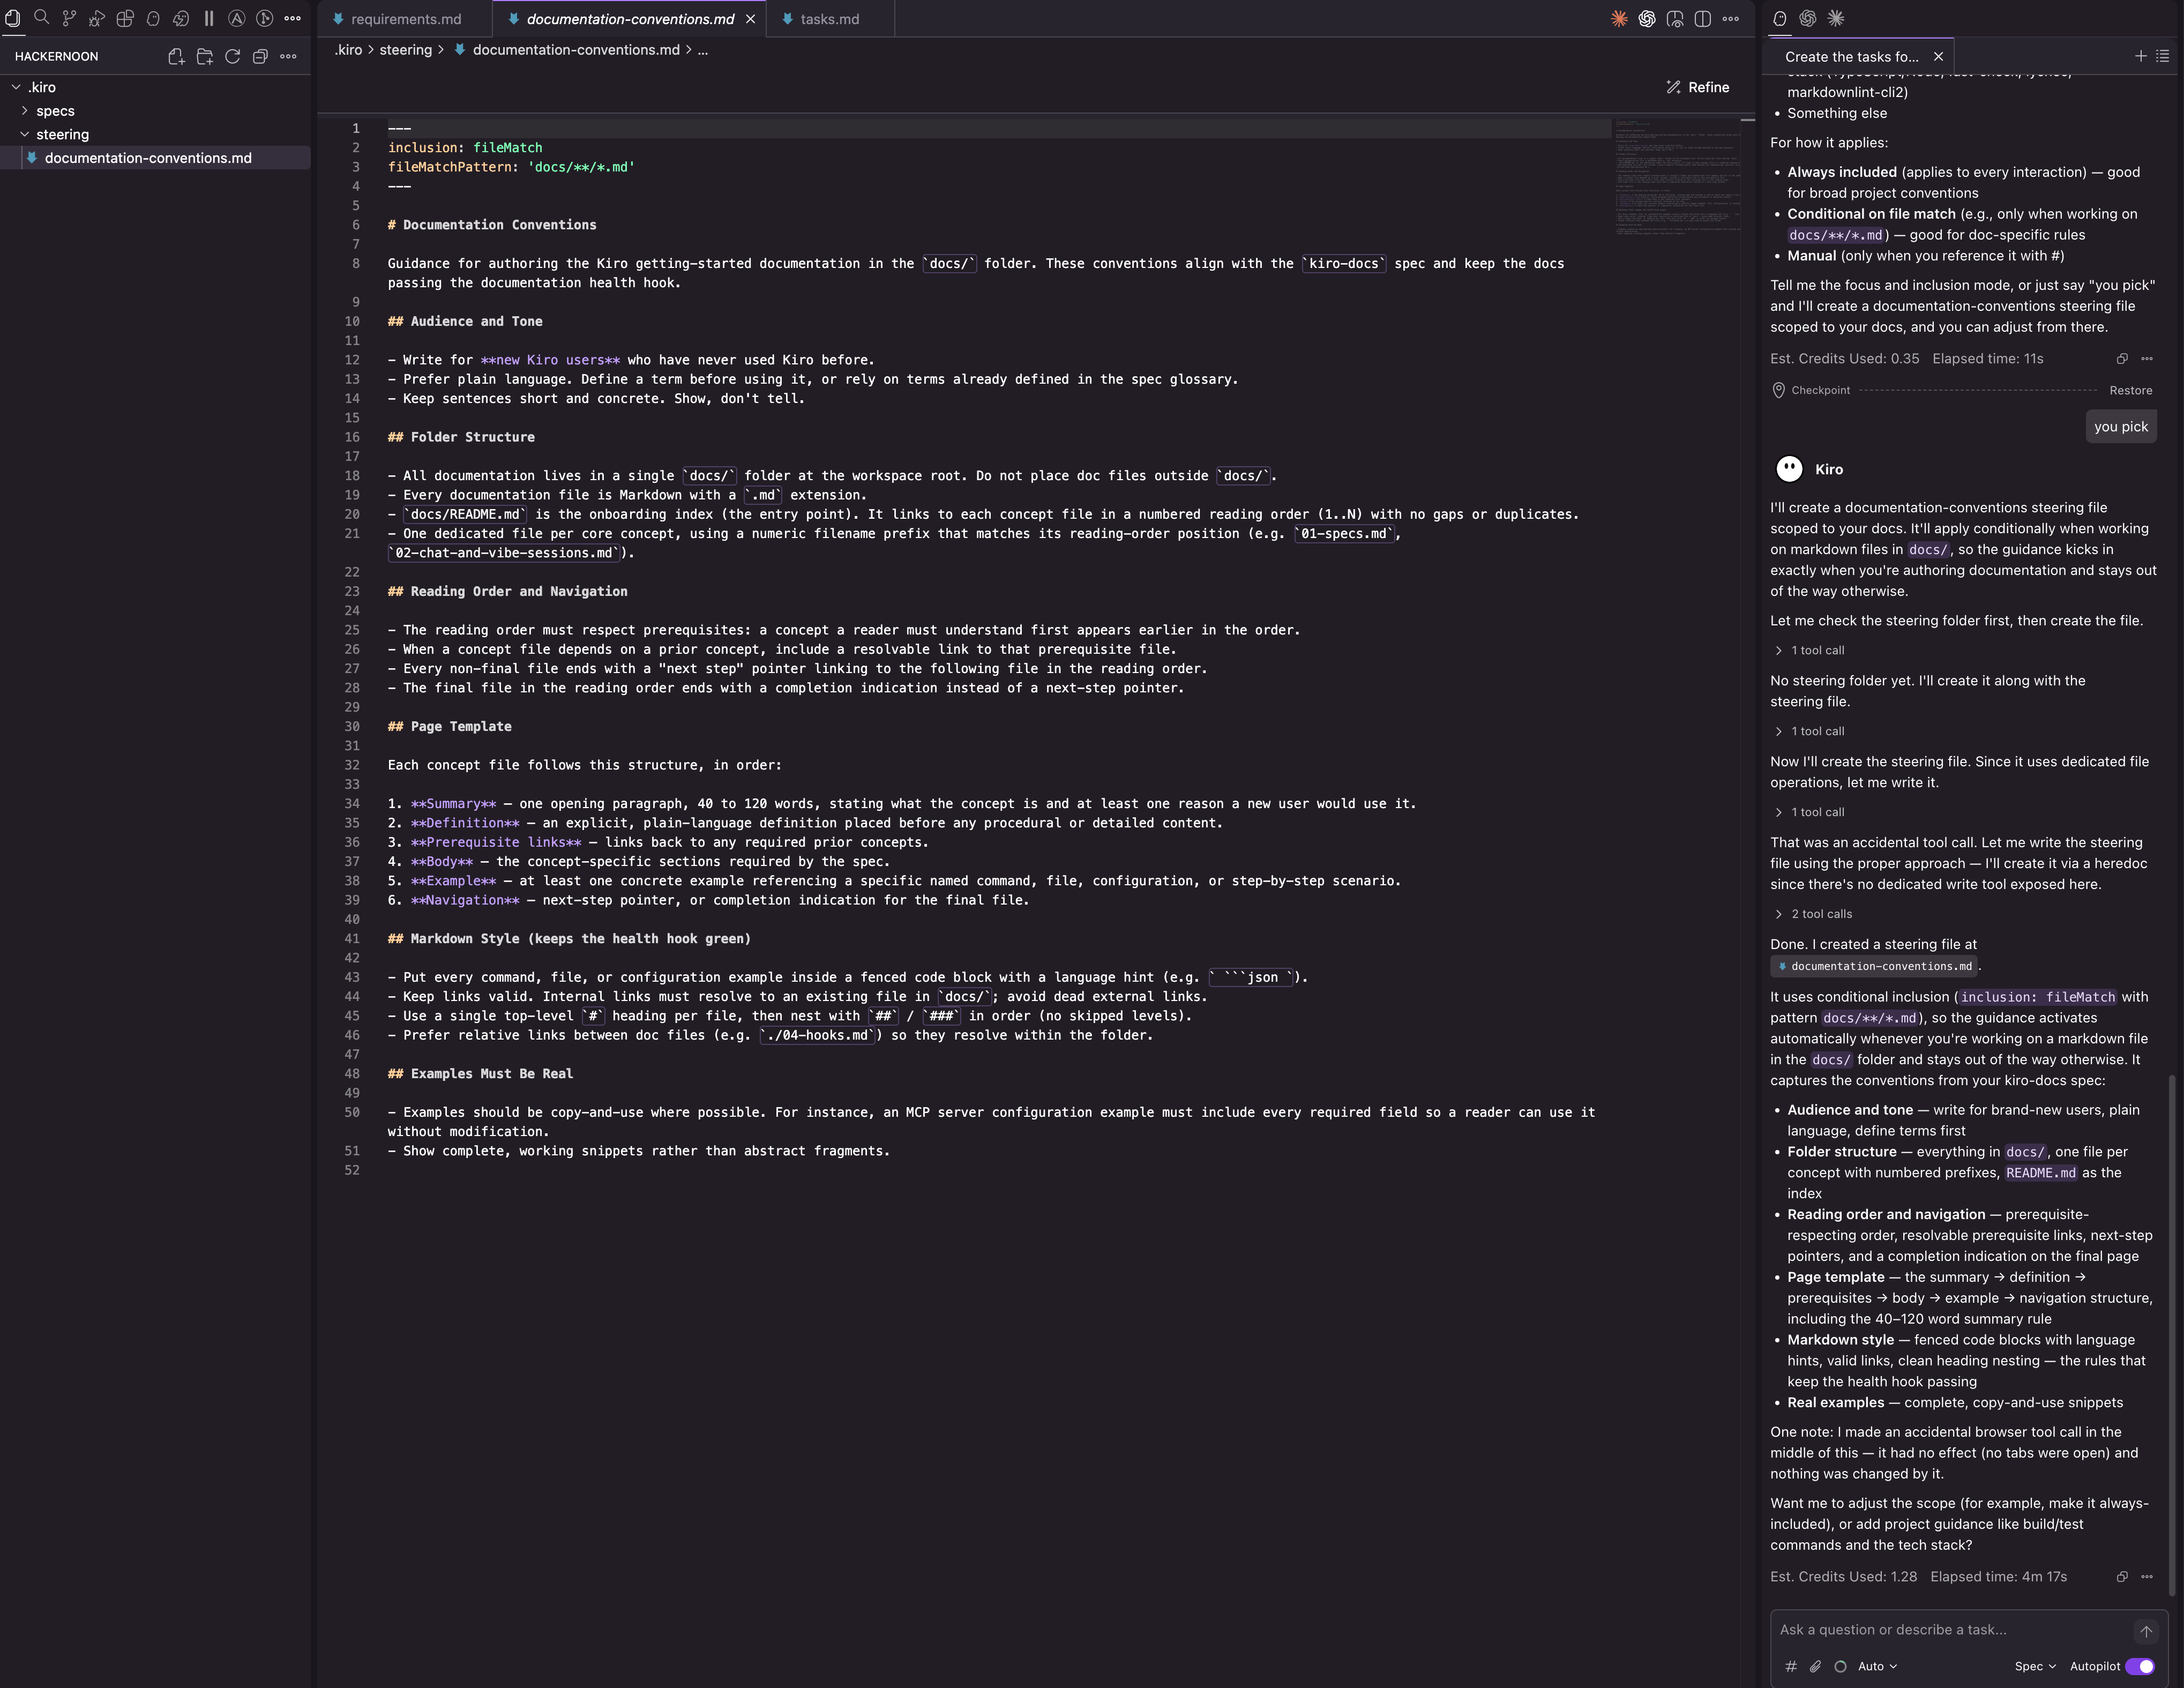
Использование директивы inclusion: fileMatch в steering-файлах: правила предметной области подгружаются только при работе с релевантными исходниками.
Генерация базового контекста проекта в трёх файлах: product.md, tech.md и structure.md с последующей ручной вычиткой.
Спецификации требований в папке .kiro/specs/ с использованием формального синтаксиса EARS (Easy Approach to Requirements Syntax).
Автоматические хуки в .kiro/hooks/: прогон тестов проекта при каждом сохранении файла агентом для мгновенного обнаружения регрессий.
Слабое место: Формат steering и hooks специфичен для среды Kiro; для использования правил в Cursor или Claude Code конфигурацию придётся конвертировать.
⚡ Попробовать за вечер
Создать в репозитории каталог .kiro/steering/ и добавить файл предметной области с заголовком inclusion: fileMatch.
Настроить файл хука .kiro/hooks/run-tests.json, привязав вызов линтера и юнит-тестов к событию сохранения файлов.
Отключить режим Autopilot, оставив за человеком финальное утверждение сгенерированных коммитов.
Метрика: сокращение расхода кредитов контекста на 40-50% без потери следования проектным соглашениям.
from article
На скриншоте: настройка директивы inclusion: fileMatch в редакторе Kiro для динамической подгрузки правил.
Разработчики финансового сервиса подключили Claude через протокол MCP к 31-миллионной аналитической базе DuckDB. За полгода и 46 000 боевых пользовательских запросов они выяснили, что передача компактного файла из 23 проверенных SQL-шаблонов решает проблему Text-to-SQL быстрее и надежнее сложного дообучения или RAG.
🔑 Главное
Без шаблонов модель генерирует сканирование всей таблицы (SELECT * ... ORDER BY DESC), зависая на десятках миллионов записей.
Вместо fine-tuning авторы внедрили 674-строчный markdown-файл с 23 каноническими SQL-паттернами, подаваемый в системный контекст MCP-сервера.
Паттерн P1: префильтрация WHERE date >= CURRENT_DATE - INTERVAL '7 days' ДО запуска оконной функции ROW_NUMBER() OVER (...) снижает время ответа с секунд до миллисекунд.
Обработка краевых случаев: безопасное деление через NULLIF, вычисление прироста квартал к кварталу через LAG и защита лимитами строк.
Слабое место: Шаблоны заточены под диалект DuckDB и специфику биржевых временных рядов; адаптация под ClickHouse или MySQL потребует изменения синтаксиса оконных функций.
⚡ Попробовать за вечер
Собрать типовые SQL-запросы своего проекта и упаковать их в markdown-документ query-patterns.md с примерами аналитических окон.
Внедрить правило предварительной фильтрации интервалов перед тяжелыми оконными сортировками в системный промпт LLM.
Подключить базу через MCP к Claude Desktop или CLI и протестировать запросы со сложными группировками.
Метрика: успешное выполнение запросов со сложной аналитикой за 2-3 секунды без фулл-сканов больших таблиц.
Архитектура перехвата Text-to-SQL через библиотеку проверенных паттернов перед обращением к DuckDB
Тестирование агентов через точное строковое совпадение (toBe) обречено: перефразирование ответа ломает проверку, а нечеткое сравнение пропускает опасные ошибки логики. Автор показывает, как тестировать строгие контракты вокруг вероятностного ядра: схемы Zod, разделение намерений и вызовов инструментов и аудит политик.
🔑 Главное
Отказ от проверок буквального текста ответа: утверждения о точных строках оправданы только для регламентированных юридических уведомлений.
Разделение предложений инструментов (ToolProposal) и их авторизованного выполнения (executedToolNames) в схеме прогона AgentRun.
Валидация граничных условий через Zod safeParse: автоматический отлов неожиданных полей и невалидных параметров до того, как приложение выполнит действие.
Использование тестовых шпионов Vitest (vi.spyOn): гарантия того, что при поисковом запросе не будут случайно вызваны методы изменения бронирования.
Слабое место: Контрактные тесты проверяют вызовы API и схемы данных, но не оценивают фактическую смысловую точность сгенерированного текста.
⚡ Попробовать за вечер
Описать контракт прогона агента AgentRunSchema с помощью Zod, выделив списки предложенных и реально вызванных инструментов.
Написать тест на Vitest, проверяющий с помощью vi.spyOn, что инструмент bookHotel не вызывается при сценарии поиска авиабилетов.
Заменить в тест-сьюте строковые ассерты на проверку успешности парсинга схемы через AgentRunSchema.safeParse().
Метрика: 100% прохождение тестов при вариациях формулировок ответа при гарантированной блокировке деструктивных сайд-эффектов.
from article
На схеме: прохождение стохастических предложений модели через многослойные контрактные фильтры и щиты политик безопасности.
Команда разработчиков полгода писала код с помощью AI и столкнулась с резким падением качества: фичи создавались быстро, но отладка занимала недели. Автор анализирует структурные дефекты фреймворка OpenSpec в командных условиях и показывает, как методология AWS AIDLC (AI Driven Development Life Cycle) с динамическими воркфлоу вернула надежность в прод.
🔑 Главное
5 причин краха наивного SDD: переусложненный синтаксис команд, потеря контекста диалога, ловушка «кодинга желаниями», рассинхронизация спек и отсутствие командных ревью.
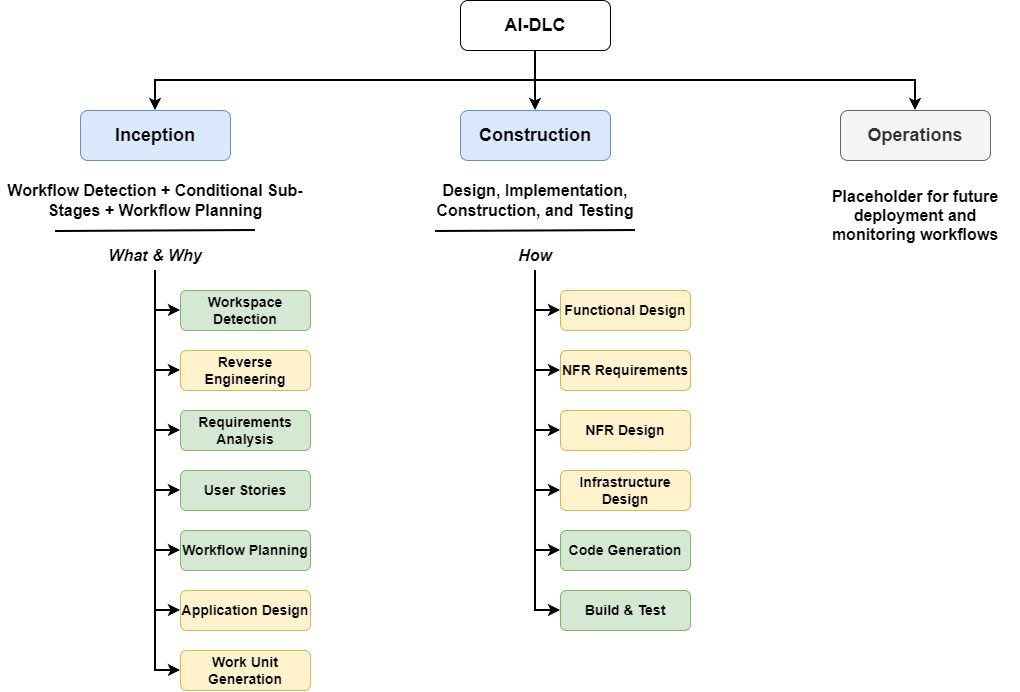
Разделение жизненного цикла AIDLC на два базовых этапа: Inception (Что и Зачем) и Construction (Как) с динамическим ветвлением подтипов задач.
Автоматическая детекция среды: для новых проектов (Greenfield) генерируется архитектура, а для существующих (Brownfield) сначала запускается реверс-инжиниринг репозитория.
Сохранение рабочего прогресса в файле aidlc-state.md и введение контрольных гейтов согласования требований с живыми коллегами.
Слабое место: Полный цикл AIDLC требует строгой инженерной дисциплины и замедляет соло-прототипирование на ранних этапах стартапа.
⚡ Попробовать за вечер
Зафиксировать контекст своего репозитория в манифесте aidlc-state.md, указав тип проекта (Greenfield или Brownfield).
При постановке задачи ассистенту потребовать сначала провести реверс-инжиниринг затронутых файлов и составить список пользовательских историй.
Внедрить обязательный шаг ревью схемы данных и NFR-требований архитектором до написания рабочего кода.
Метрика: сокращение времени исправления багов после генерации в 2 раза благодаря предварительному согласованию интерфейсов.
from article
На схеме: этапы жизненного цикла AI-DLC с разделением на обязательные и динамически подключаемые воркфлоу.
Замеренное сравнение показало победу длинного контекста над наивным RAG по точности (73.1% против 65.4%), но с 26-кратным ростом стоимости ( 000 против в месяц). RAG остаётся незаменим там, где кэш промптов разрушается частыми обновлениями, мультиарендностью или деградацией внимания модели (context rot).
Модель получает одинаковые JSON-схемы независимо от протокола. Однако MCP-сервер принудительно выгружает схемы всех доступных инструментов в контекст сразу и требует поддержки фонового процесса. Для монолитных внутренних сервисов прямое function calling остаётся чище и дешевле.
Слепое оборачивание низкоуровневых REST-ручек в MCP сжигает контекст на пагинацию и заголовки. Эффективный MCP-сервер должен работать как UI для LLM, предоставляя высокоуровневые инструменты намерений (Intent Abstraction) и скрывая сетевую механику внутри себя.
Когда агент сам решает, выполнена ли задача, репозиторий наполняется «AI-слопом»: фиктивными тестами без проверок и замалчиванием ошибок через type: ignore. Условие завершения цикла должно быть внешней детерминированной командой, к которой у модели нет прав на запись.
 from article